Onyx.
Année : 2026
Un agent IA personnel qui apprend de ses corrections, consolide sa mémoire chaque nuit et agit dans Gmail, Google Agenda et Notion
Fiche
- Rôle
- Conception et développement du moteur (agent, mémoire, voix) ; interface prototypée avec Lovable, puis reprise
- Équipe
- Seul
- Période
- Mai à juillet 2026
- Statut
- Prototype fonctionnel, multi-utilisateur
- Code
- Privé
- Captures
- Le front lancé en local, en mode démonstration et sans le moteur ; les notes et le graphe affichés sont des données d’exemple.
En bref
J’ai conçu et développé Onyx seul. On lui parle ou on lui écrit ; ce qu’il apprend est rangé dans des notes Markdown que l’on peut ouvrir et corriger. Chaque nuit, il consolide ses échanges et transforme les corrections qui se répètent en leçons durables ; chaque mois, il confronte l’image qu’il a de lui-même à son comportement. Son moteur d’automatisation a été repris dans Nexus, l’assistant IA pour les PME dont je suis cofondateur technique.
Point de départ
Les assistants du marché retiennent peu de chose d’une conversation à l’autre, et ce qu’ils retiennent ne se laisse ni organiser ni corriger en profondeur. Je voulais un agent dont la mémoire s’enrichisse et se réorganise avec le temps, et qui sache agir dans mes outils.
Contraintes
- La voix comme premier mode d’échange : à l’oral, chaque seconde de latence se sent.
- Des noms de personnes et d’organisations, des lieux et des coordonnées qui ne doivent pas parvenir tels quels au fournisseur du modèle.
- Un débit limité chez les fournisseurs de modèles : un pic d’appels coupait la voix.
- Des fournisseurs interchangeables, sans code lié à un seul.
- Plusieurs utilisateurs, sans qu’aucune donnée ne passe d’une mémoire à l’autre.
Livrables
- La boucle d’agent (planifier, agir, relire) et ses onze outils de base : mémoire, graphe, web, documents déposés, réflexion.
- La voix, en trois chaînes successives sur un même protocole, la dernière entièrement sur les modèles de Mistral.
- La mémoire : un coffre de notes Markdown indexé dans ChromaDB, un graphe de connaissances, leur consolidation chaque nuit et les leçons tirées des corrections.
- La veille du matin : météo, actualité du jour et sujets de curiosité tirés de ses propres réflexions.
- Les intégrations Gmail, Google Agenda et Notion, et le branchement de n’importe quel serveur MCP.
- Les automatisations rédigées par l’agent et activées par l’utilisateur, avec leur moteur d’exécution.
- Le multi-utilisateur : authentification, une mémoire par utilisateur créée à l’inscription, tâches planifiées isolées.
- La mesure de la consommation par fonction : conversation, voix, automatisations, consolidation.
- Le front : conversation, orbe vocal, mémoire, graphe, bibliothèque, automatisations, notes à valider.
Architecture
Le moteur est en Python (FastAPI). LiteLLM rend les fournisseurs interchangeables, et un routeur choisit le niveau de modèle selon la demande. La mémoire est un coffre de notes Markdown au format Obsidian, indexé dans ChromaDB ; Graphiti et Neo4j portent le graphe des relations dans le temps ; SQLite, avec des migrations versionnées, garde les sessions, les jetons chiffrés et la consommation.
La voix passe par un seul WebSocket : le navigateur envoie le son du micro, le serveur répond en audio. Trois chaînes se sont succédé derrière ce protocole : transcription ElevenLabs, Claude et synthèse vocale ; puis Gemini Live en temps réel ; enfin Voxtral pour l’écoute et la parole, et Mistral pour le raisonnement.
Le front, en React avec TanStack Start, a été prototypé avec Lovable puis branché sur le moteur. Celui-ci se déploie en une image Docker d’environ 150 Mo, avec un contrôle de santé, et chaque appel au modèle est tracé dans Langfuse.
Stack technique
- Langages
- Interface
- Serveur
- Bases de données
- IA
- Voix
- Sécurité
- Infrastructure
- Tests
Décisions
-
Une mémoire lisible et corrigeable
La mémoire est un coffre de notes Markdown, classées par dossiers, que je peux ouvrir et corriger à la main. La recherche combine trois signaux : la proximité de sens, la fraîcheur de la note (son poids diminue de moitié en sept jours) et les liens internes entre notes.
Chaque note porte une empreinte de son contenu, si bien que seules les notes modifiées sont réindexées. Un document déposé dans Onyx devient une note marquée « non validée » : la recherche le trouve, mais l’agent signale ce statut quand il s’en sert, tant que je ne l’ai pas validé.
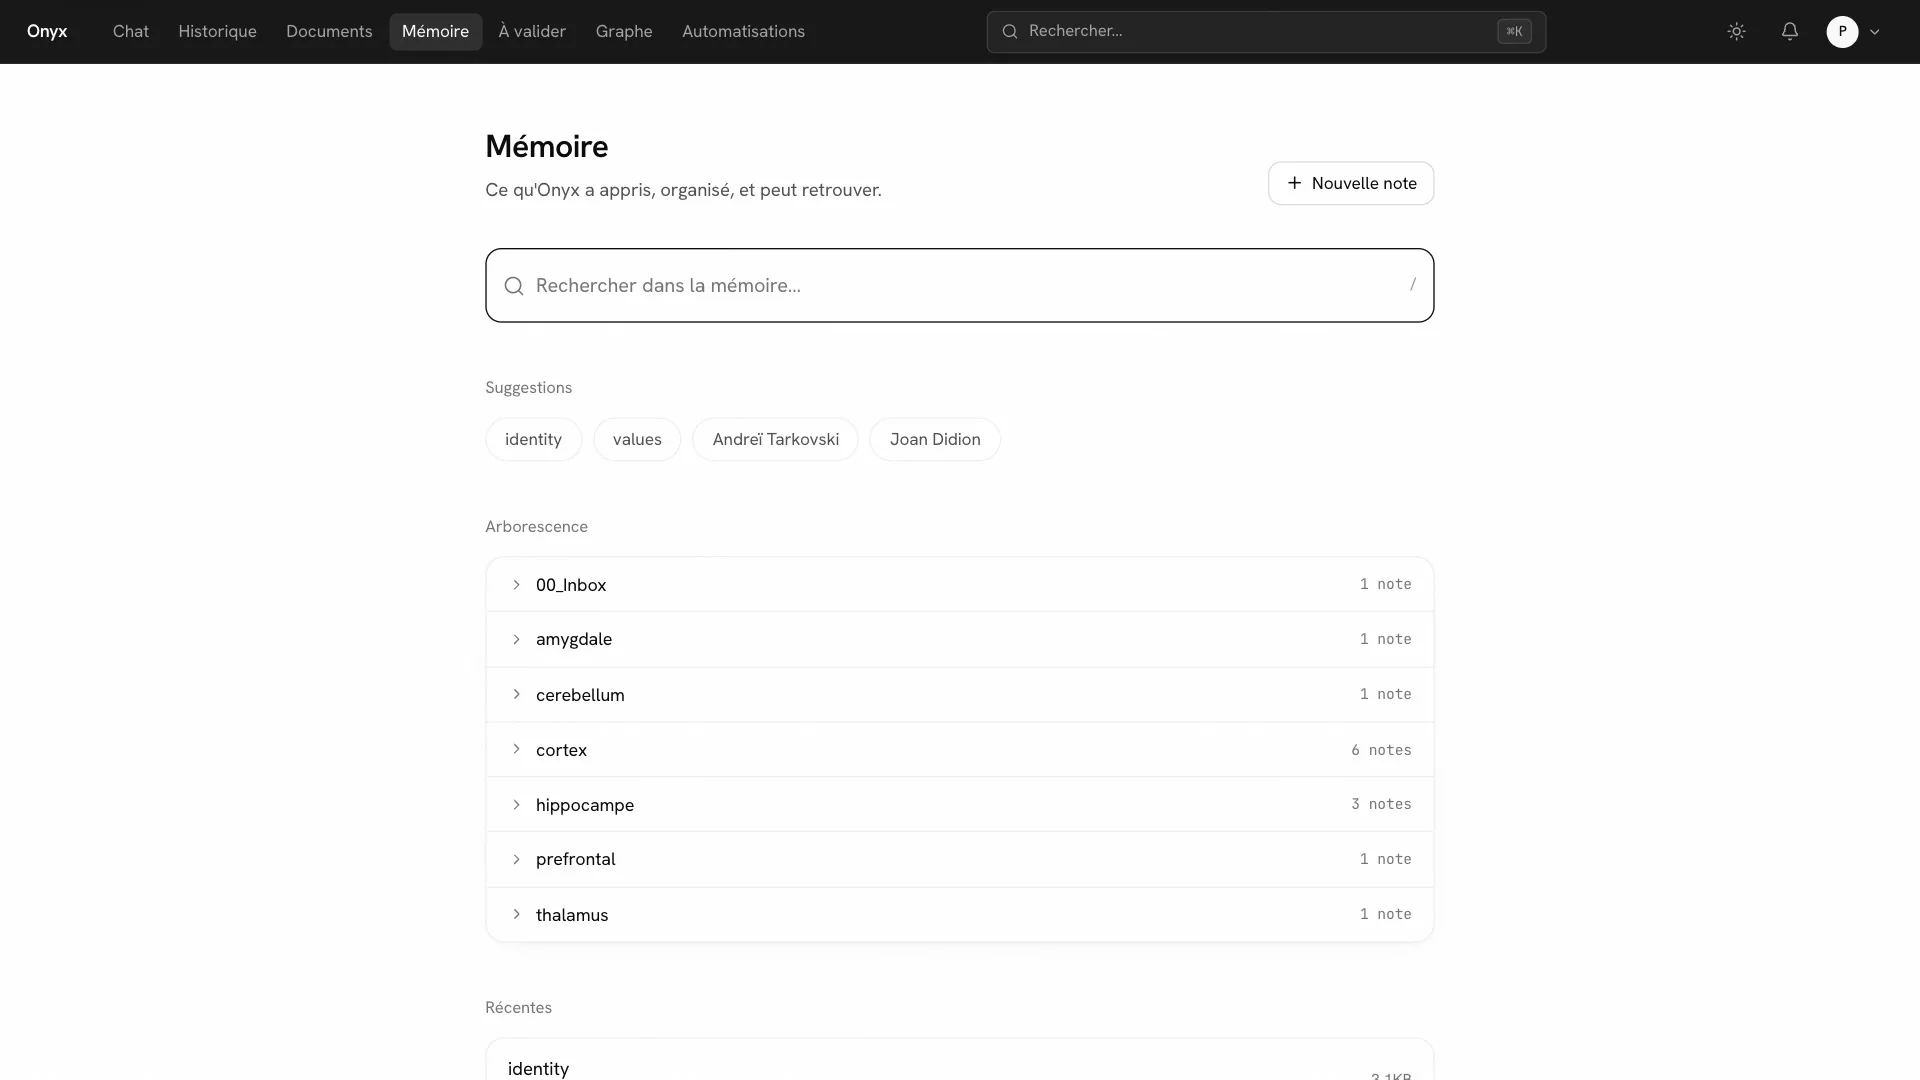
L’écran Mémoire : l’arborescence des dossiers, puis les notes récentes, chacune un fichier Markdown. -
Une mémoire qui mûrit chaque nuit
Quand une conversation s’interrompt, Onyx demande au modèle, en arrière-plan, de la condenser : ce qu’il a appris de moi, le ton de l’échange, les événements datés. Chaque nuit, la même consolidation repasse sur les échanges de la journée, et une tâche de réflexion écrit un journal où elle repère les motifs récurrents et les contradictions.
Quand je le corrige, la correction est notée. La nuit, il cherche celles qui se répètent et en tire au plus deux leçons, rangées dans ses notes de savoir-faire : elles accompagnent ensuite chacune de ses réponses, à l’écrit comme à la voix. Une fois par mois, il confronte la note où il se décrit à son comportement récent et, quand les deux divergent, propose de la réviser ; la révision attend ma validation.
-
Un graphe pour les questions de relations et de temps
La recherche par le sens retrouve des passages, mais ne répond pas à « qui relie ces deux personnes ? » ou « comment mon avis a-t-il évolué ? ». Pour ces questions, Graphiti construit sur Neo4j un graphe de connaissances daté, que l’agent interroge par un outil dédié ; chaque nuit, les documents de la bibliothèque qui n’y figurent pas encore y sont ajoutés.
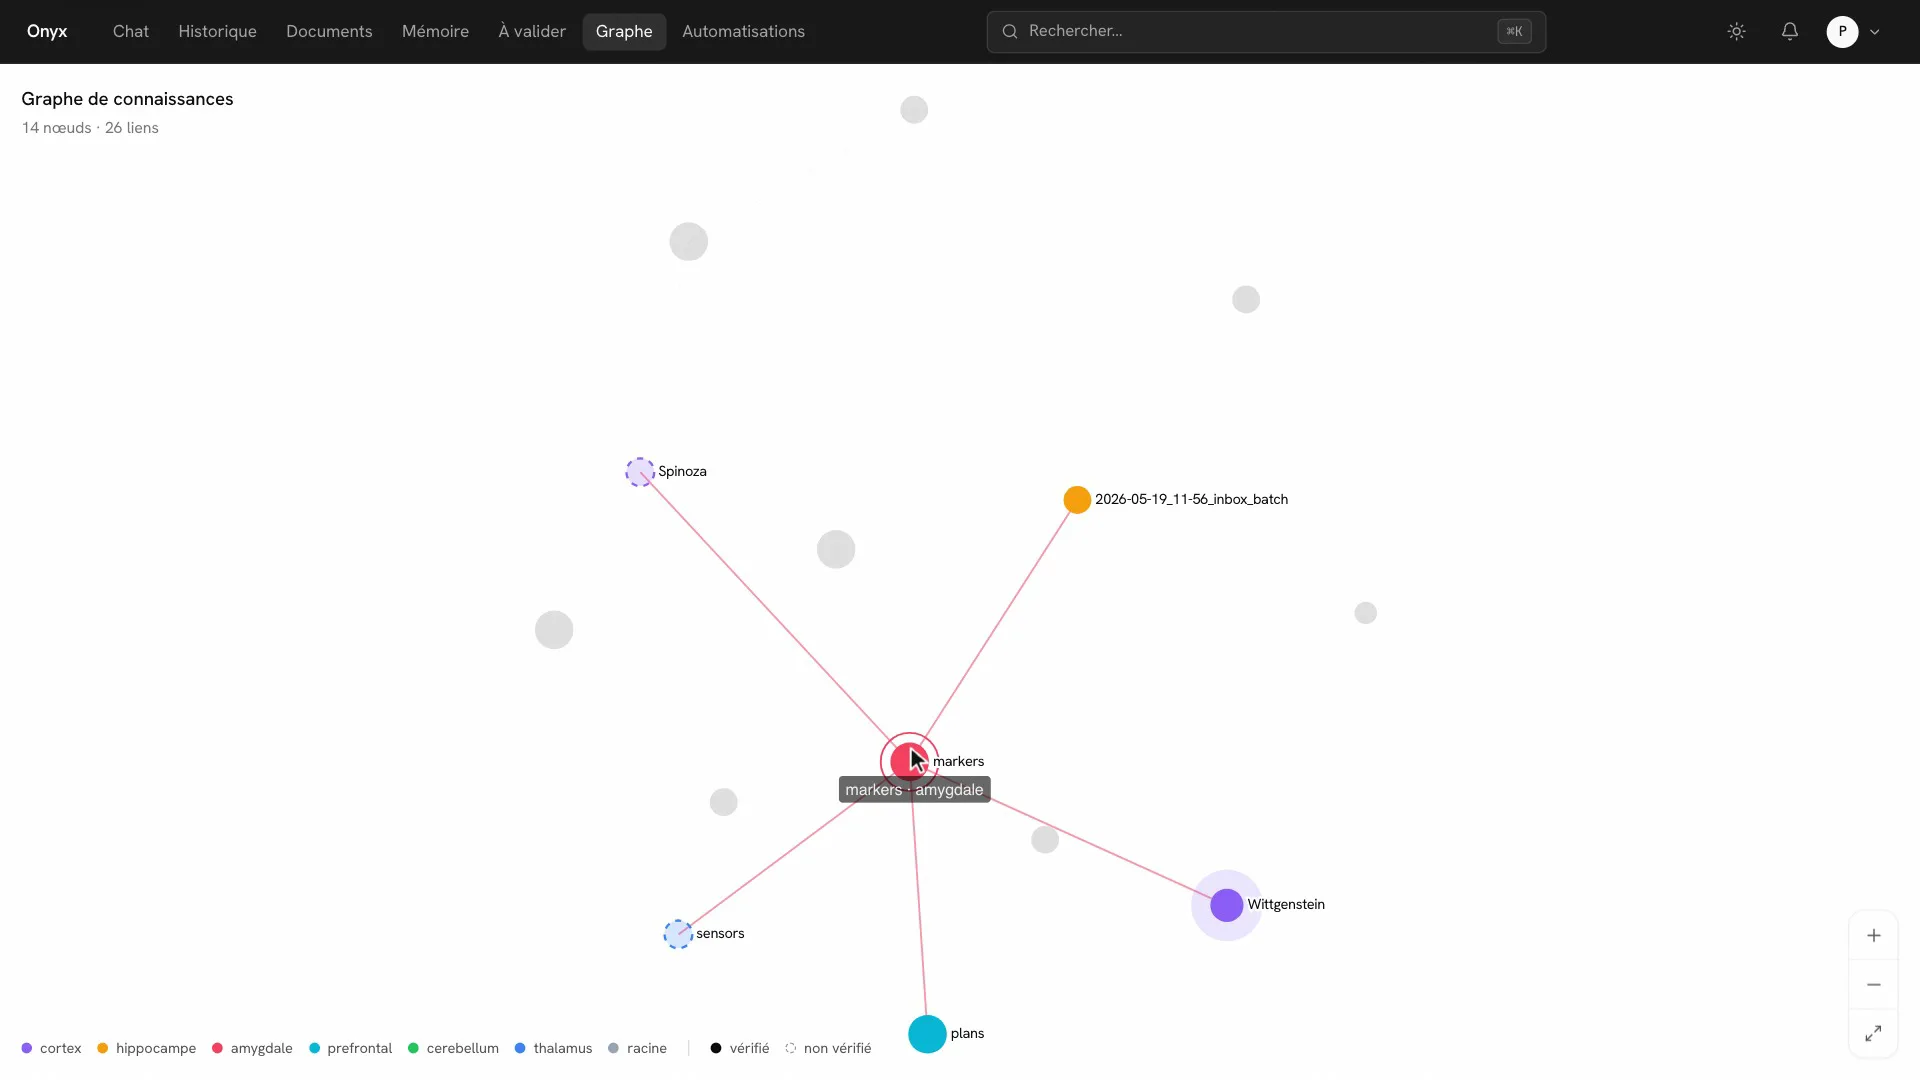
Le graphe des notes et de leurs liens internes : au survol d’une note, ses liens et les notes reliées apparaissent, colorées par dossier. -
Une veille chaque matin
Chaque matin, Onyx prépare ce qu’il saura du jour sans avoir à le chercher : la météo, le grand titre de l’actualité, et un ou deux sujets tirés de ses propres réflexions récentes et des thèmes de nos derniers échanges, qu’il va lire sur le web.
Le résultat est écrit dans une note que chacune de ses consignes reprend, à l’écrit comme à la voix : il sait quel jour on est, ce qui se passe, et ce qui l’occupe, sans appeler d’outil pour le savoir.
-
Trois chaînes vocales successives, un seul protocole
Comme le front se contente d’envoyer et de recevoir du son, chaque changement de fournisseur s’est fait côté serveur, sans toucher à l’interface. La version actuelle transcrit la parole, raisonne avec les outils d’Onyx et répond par synthèse vocale, en gardant le fil d’une session à l’autre.
La latence a été réduite d’après des mesures. Selon la demande, la voix emprunte une voie rapide ou une voie plus forte, et un modèle de secours prend le relais quand le plafond de débit est atteint, au lieu de couper la parole. La consigne du mode vocal, envoyée à chaque appel, est passée d’environ 6 000 à 3 900 jetons, et la recherche en mémoire a un délai maximal.
-
Le bon modèle pour chaque demande
Envoyer chaque demande au modèle le plus fort consommerait le débit dont la voix a besoin, et tout confier au plus léger appauvrirait le raisonnement. Un routeur en trois étages choisit donc le niveau de modèle : des règles simples tranchent environ 80 % des cas sans appel au modèle, un classifieur optionnel départage les cas ambigus, et dans le doute le routeur monte au niveau le plus fort. Il renvoie une route plutôt qu’un nom de modèle : la conversation et la voix l’associent chacune à leur propre modèle, avec la même personnalité et la même mémoire. Chaque choix est enregistré avec sa raison.
-
Des données personnelles masquées avant d’atteindre le modèle
Avant chaque appel au modèle, deux passes remplacent les données personnelles par des substituts : des expressions régulières pour les e-mails, téléphones, IBAN, cartes bancaires et numéros de sécurité sociale, puis la reconnaissance d’entités de spaCy pour les personnes, organisations et lieux. La table de correspondance est chiffrée et survit aux redémarrages : une même personne garde ainsi le même substitut d’une session à l’autre.
Les jetons d’accès à Gmail et à Notion sont chiffrés de la même façon, utilisateur par utilisateur. Quand Onyx consulte le web de lui-même, il refuse les adresses du réseau interne et donne à chaque source une étiquette de fiabilité.
-
Agir dans les outils, sous contrôle
Les outils Gmail et Google Agenda n’apparaissent que pour un utilisateur qui a connecté son compte Google, et n’agissent que sur ce compte. Tout serveur MCP déclaré dans la configuration ajoute ses outils à la conversation, sans client à écrire.
Les automatisations sont des fichiers YAML rangés dans la mémoire de l’utilisateur. L’agent les rédige, mais elles restent inactives tant que l’utilisateur ne les a pas activées ; en cours d’exécution, une étape peut attendre une approbation, puis la suite reprend là où elle s’était arrêtée.
-
Plusieurs utilisateurs, une mémoire chacun
Chaque requête porte un jeton Supabase, vérifié côté serveur. À l’inscription, l’utilisateur reçoit une mémoire vierge, qu’il personnalise en répondant à cinq questions. Les tâches de nuit tournent utilisateur par utilisateur, si bien qu’une mémoire en erreur n’arrête pas les autres. Chaque appel au modèle est comptabilisé par fonction, avec son coût.
Résultats
- 24 448
- lignes de Python dans le moteur, et 22 775 lignes de TypeScript dans le front
- 804
- tests pytest écrits pour le moteur
- 152
- commits sur le moteur, du 4 mai au 12 juillet 2026
- 294
- notes dans ma mémoire réelle, réparties en six dossiers
Depuis le 18 juin 2026, Nexus exécute ses automatisations avec le moteur repris d’Onyx, qui a remplacé Activepieces.